En bref : Ces trois expressions ne décrivent pas la même chose, et c'est la source de la plupart des malentendus. L'IA locale désigne un modèle qui tourne sur une machine que vous maîtrisez. L'IA souveraine désigne la capacité à garder le contrôle de l'ensemble, hébergement compris, face à des contraintes juridiques étrangères. L'IA européenne désigne l'origine du fournisseur ou du modèle, ce qui ne dit rien à lui seul du lieu où tournent les calculs. Pour décider, séparez trois couches : où sont vos données, à qui appartient le modèle et avec quoi il a été entraîné. Pour une TPE ou une PME, la première couche est de loin la plus déterminante.
Un commercial vous présente une offre d'IA « souveraine ». Un autre parle d'« IA européenne ». Un troisième vous propose d'installer un modèle « en local, chez vous ». Les trois emploient un vocabulaire de garantie, et aucun ne répond exactement à la même inquiétude.
Derrière ces mots, il n'y a pas une échelle de qualité mais trois questions distinctes, qui se posent séparément et se vérifient séparément. Un outil peut parfaitement être européen et héberger vos données hors d'Europe, ou tourner sur un serveur français avec un modèle dont le corpus d'entraînement n'est pas documenté.
Cet article pose ces trois questions dans l'ordre où elles comptent pour une petite structure, et donne les quatre vérifications à faire avant de confier le moindre fichier client à un outil.
Trois mots, trois questions différentes
Commençons par les définitions, telles qu'elles sont employées dans les offres que vous rencontrez.
IA locale. Le modèle est exécuté sur une machine que vous contrôlez : un serveur dans vos murs, ou une instance que vous louez et administrez. Rien de ce que vous saisissez ne sort de cette machine. C'est la configuration la plus protectrice, et la plus exigeante en compétences et en matériel.
IA souveraine. L'expression désigne la capacité à garder le contrôle de la chaîne entière, et notamment à ne pas dépendre d'une décision ou d'une injonction étrangère. Elle recouvre l'hébergement, mais aussi la possibilité de changer de fournisseur sans tout reconstruire.
IA européenne. L'expression désigne l'origine du fournisseur, et parfois celle du modèle. Elle est utile, mais elle ne garantit par elle-même ni le lieu d'hébergement ni la nature du corpus d'entraînement. Un éditeur européen peut s'appuyer sur l'infrastructure d'un acteur non européen.
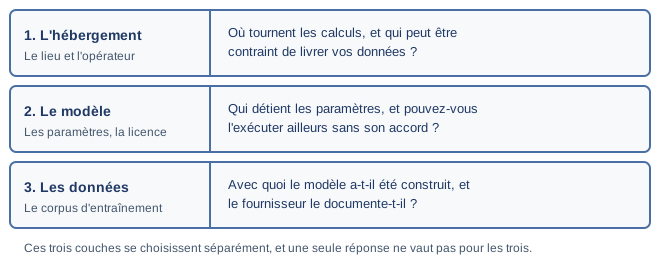
Trois couches indépendantes. Un hébergement en France ne dit rien du modèle employé ni de son corpus d'entraînement.
Ces trois couches se vérifient une par une. Posées ensemble, elles donnent une image bien plus utile qu'un adjectif figurant sur une plaquette.
Où sont vos données, et qui peut y accéder
C'est la couche qui a des conséquences concrètes et immédiates pour un cabinet d'expertise comptable, un bureau d'études ou une étude notariale, parce qu'elle touche à des dossiers couverts par le secret professionnel.
En France, le repère officiel sur ce point est la qualification SecNumCloud, délivrée par l'Agence nationale de la sécurité des systèmes d'information. L'ANSSI indique qu'elle reconnaît des offres cloud dites de confiance, et qu'elle vise en particulier à protéger les données et traitements sensibles contre la cybercriminalité et contre les lois extraterritoriales. Elle précise aussi une limite importante : la qualification ne garantit pas le niveau de sécurité des services hébergés sur ces offres. Autrement dit, un outil installé sur une infrastructure qualifiée n'est pas pour autant un outil sûr.
L'ANSSI a publié en juillet 2024 des recommandations dédiées à l'hébergement des systèmes d'information sensibles dans le cloud, qui constituent une base de lecture pour toute structure manipulant des dossiers confidentiels.
Le sujet bouge aussi au niveau européen. La Commission européenne a présenté le 3 juin 2026 une proposition de règlement sur le développement du cloud et de l'IA, qui prévoit notamment un cadre d'évaluation unique à l'échelle de l'Union pour la souveraineté du cloud et de l'IA. Ce texte est une proposition et non une obligation en vigueur, mais il indique la direction : la souveraineté deviendra un critère évaluable plutôt qu'un argument commercial.
Pour vous, la question pratique tient en une phrase : où sont stockées mes données, et qui, juridiquement, peut être contraint de les communiquer ?
À qui appartient le modèle, et pouvez-vous en changer
La deuxième couche concerne le modèle lui-même, et surtout votre capacité à en sortir.
Un modèle accessible uniquement par l'interface de son concepteur vous lie à ses tarifs, à sa feuille de route et à sa disponibilité. Un modèle dont les paramètres sont publiés, ce que l'on appelle un modèle à poids ouverts, peut être exécuté sur une infrastructure que vous choisissez et adapté sans l'accord de son auteur. La différence ne porte pas sur la performance brute, mais sur la réversibilité.
Cette logique est la même que celle que nous décrivons pour les plateformes d'automatisation dans notre article sur le choix d'un socle d'automatisation : ce qui coûte cher, ce n'est pas l'abonnement, c'est l'impossibilité de partir.
Pour une petite industrie qui intègre un modèle dans une application métier, la question à trancher dès le cahier des charges est celle du point de bascule : si ce fournisseur double son tarif ou ferme son service dans deux ans, combien de jours de travail faut-il pour le remplacer ? Si la réponse est « on repart de zéro », le choix technique est à revoir avant le développement, pas après.
Faites inscrire dans votre contrat la possibilité de changer de modèle sans réécrire l'application.
D'où viennent les données d'entraînement
La troisième couche est la moins visible et la plus difficile à vérifier seul. Elle n'est pas pour autant hors de portée.
Le règlement européen sur l'intelligence artificielle impose depuis le 2 août 2025, à son article 53, à tout fournisseur de modèle d'IA à usage général de publier un résumé suffisamment détaillé des contenus utilisés pour l'entraînement, selon un modèle fourni par le Bureau de l'IA, et d'appliquer une politique de respect du droit d'auteur de l'Union. Les modèles publiés en source ouverte ne sont pas exemptés de ces deux obligations. Vous pouvez donc demander ces documents, et constater quand ils n'existent pas. Nous avons replacé l'ensemble de ces obligations dans notre guide du règlement européen sur l'IA pour les TPE et PME, et la question voisine de la propriété des contenus produits dans notre article sur l'IA et la propriété intellectuelle.
Du côté des données personnelles, le Comité européen de la protection des données a adopté le 7 juillet 2026 des lignes directrices sur l'anonymisation et sur le moissonnage de données dans le contexte de l'IA générative. Elles rappellent que le règlement général sur la protection des données s'applique dès que le moissonnage porte sur des données personnelles, et qu'il n'existe pas d'exemption générale pour l'entraînement des modèles. Ces deux textes ont été soumis à consultation publique jusqu'au 30 octobre 2026, et leur version définitive est à suivre.
Enfin, la CNIL met à disposition un démonstrateur, Genmod, mis à jour le 26 août 2026, qui permet d'explorer la généalogie des modèles publiés en source ouverte, c'est-à-dire les modèles dont un modèle dérive et ceux auxquels il a servi de base. L'outil a été conçu pour étudier la mémorisation de données d'entraînement : un modèle ayant mémorisé des données personnelles permet de repérer ceux de sa lignée susceptibles de conserver les mêmes informations. C'est un rappel utile qu'un modèle ouvert n'est pas un modèle sans histoire.
Ce qui compte vraiment pour une TPE ou une PME
Il est tentant de vouloir répondre aux trois couches d'un coup, en installant un modèle sur un serveur maison. Dans la plupart des cas, c'est une mauvaise affectation de vos moyens. Un serveur à administrer, à sauvegarder et à mettre à jour crée un risque opérationnel que peu de structures de moins de cinquante personnes absorbent sereinement.
L'ordre de priorité que nous appliquons est le suivant.
| Priorité | Question | Pourquoi elle passe avant les autres |
|---|---|---|
| 1 | Où sont stockées les données que vous saisissez, et sont-elles utilisées pour entraîner un modèle ? | C'est le seul point qui peut faire sortir des informations clients de votre contrôle dès le premier usage |
| 2 | Quelles données acceptez-vous de confier à l'outil, et lesquelles restent exclues ? | Une règle interne claire protège mieux qu'un hébergement parfait sans règle d'usage |
| 3 | Combien de temps faut-il pour changer de fournisseur ? | C'est ce qui détermine votre marge de négociation dans trois ans |
| 4 | Le fournisseur documente-t-il son corpus d'entraînement et sa politique de droit d'auteur ? | C'est un signal de sérieux, et un critère de comparaison objectif entre deux offres |
Une configuration locale devient pertinente quand la nature des données l'exige vraiment : dossiers médicaux, secrets industriels et pièces couvertes par le secret professionnel. Pour un garage, un commerce ou un cabinet de conseil, une offre hébergée en Europe, avec un engagement écrit de non-réutilisation des saisies et une règle interne sur ce qui ne s'y met pas, couvre l'essentiel du risque.
Chez Pivox, nous instruisons ces quatre questions au début de chaque projet, et nous écrivons la réponse dans le cahier des charges plutôt que dans une annexe commerciale. Les repères que nous appliquons sont rassemblés sur notre page engagement IA responsable.
Les quatre questions à poser à un fournisseur
- Dans quel pays sont hébergées les données que nous saisissons, et par quelle société sont exploités les serveurs ?
- Nos saisies sont-elles utilisées pour entraîner ou améliorer un modèle, et où cet engagement est-il écrit ?
- Quel modèle est employé, et pouvons-nous le remplacer par un autre sans réécrire l'application ?
- Pouvez-vous nous transmettre le résumé des données d'entraînement et la politique de droit d'auteur du fournisseur du modèle ?
Une offre sérieuse répond aux quatre par écrit. Une hésitation sur la première est un motif suffisant pour reporter la décision.
Questions fréquentes
Une IA hébergée en France est-elle automatiquement conforme au RGPD ?
Non. Le lieu d'hébergement est un élément parmi d'autres. La conformité dépend aussi de la base légale du traitement, de l'information des personnes, de la durée de conservation et de l'existence d'un contrat de sous-traitance en règle. Un hébergement en France simplifie la question des transferts hors Union européenne, mais il ne remplace aucune des autres obligations.
Faut-il installer un modèle sur nos propres serveurs ?
Rarement, dans une structure de moins de cinquante personnes. Un modèle installé chez vous suppose du matériel adapté, des mises à jour, des sauvegardes et une personne capable d'intervenir. Ce choix se justifie quand les données traitées sont réellement sensibles, par exemple des dossiers couverts par le secret professionnel ou des secrets industriels. Dans les autres cas, une offre hébergée en Europe avec un engagement écrit de non-réutilisation des saisies couvre l'essentiel.
Que vaut la qualification SecNumCloud pour une petite entreprise ?
C'est le repère français le plus solide sur l'hébergement, délivré par l'ANSSI, et il vise explicitement la protection contre la cybercriminalité et contre les lois extraterritoriales. L'ANSSI précise toutefois que la qualification porte sur l'offre d'hébergement et non sur les services qui tournent dessus. Pour une petite entreprise, c'est un critère de confiance utile, et non une garantie que l'outil que vous utilisez est bien conçu.
Un modèle à poids ouverts est-il plus sûr ?
Il est plus réversible, ce qui n'est pas la même chose. Pouvoir télécharger les paramètres d'un modèle vous permet de l'exécuter où vous le souhaitez et de changer de prestataire sans repartir de zéro. Cela ne dit rien de la qualité de son corpus d'entraînement ni de la présence éventuelle de données personnelles mémorisées, un sujet que la CNIL documente avec son outil Genmod.
Comment savoir sur quoi un modèle a été entraîné ?
En demandant le résumé des contenus d'entraînement, que tout fournisseur de modèle d'IA à usage général doit publier depuis le 2 août 2025 au titre du règlement européen sur l'intelligence artificielle. Ce résumé suit un format fourni par le Bureau de l'IA de la Commission européenne. Son absence, ou un refus de le transmettre, est en soi une information utile pour comparer deux offres.
Nos salariés utilisent déjà des outils grand public, est-ce un problème ?
C'est le point à traiter en premier, avant toute question d'hébergement. Une règle interne écrite, qui dit quelles données ne se mettent pas dans un outil en ligne, protège davantage qu'un changement de fournisseur. Nous avons détaillé le cadre applicable dans notre article sur ce que la loi impose quand vos équipes utilisent ChatGPT ou Claude.
Sources principales
- Agence nationale de la sécurité des systèmes d'information, Cloud et qualification SecNumCloud, consulté en octobre 2026
- Commission européenne, Proposal for the Cloud and AI Development Act, 3 juin 2026
- Comité européen de la protection des données, lignes directrices sur l'anonymisation et sur le moissonnage dans le contexte de l'IA générative, adoptées le 7 juillet 2026, présentation par la CNIL
- CNIL, Genmod, outil de traçabilité des modèles d'IA publiés en source ouverte, mise à jour du 26 août 2026
- Règlement (UE) 2024/1689 sur l'intelligence artificielle, article 53, obligations applicables depuis le 2 août 2025